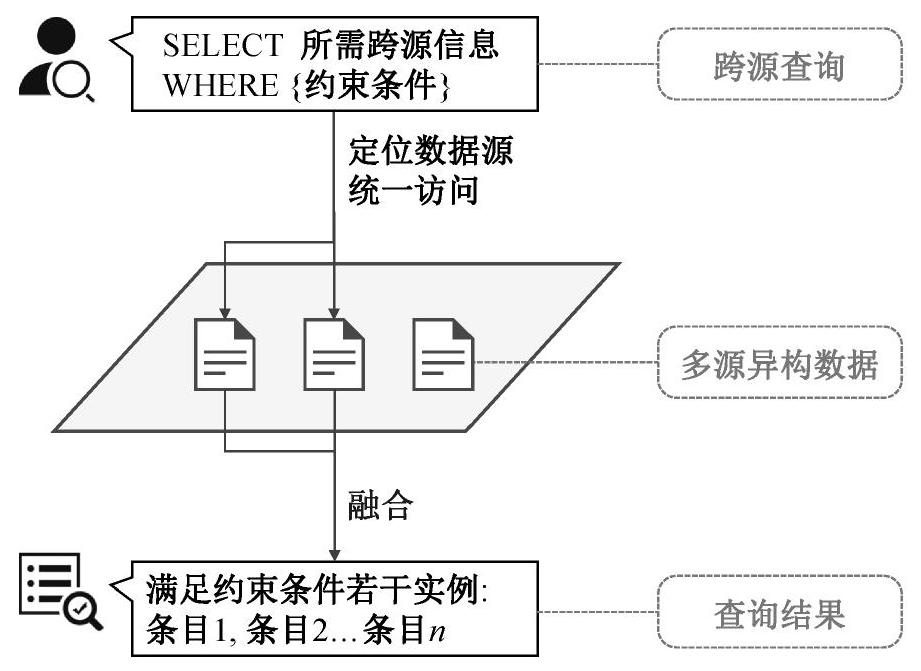
图1 面向多源异构数据的查询任务
Fig.1 Query tasks for multi-source heterogeneous data
北京大学学报(自然科学版) 第62 卷 第4 期 2026 年7 月
Acta Scientiarum Naturalium Universitatis Pekinensis, Vol. 62, No. 4 (July 2026)
doi: 10.13209/j.0479-8023.2025.089
国家自然科学基金(U23A20296, 62272469, 62302513)和湖南省科技创新计划(2023RC1007)资助
收稿日期: 2025-06-30;
修回日期: 2025-08-19
RDF-MT Mapping Strategies and Verification under Multi-source Heterogeneous Scenarios
在数字化时代, 高效管理和利用数据成为企业运营、科学研究和决策制定的关键[1]。数据访问与查询是数据管理的重要一环, 随着多源异构数据规模的爆炸式增长和多样化应用场景的不断涌现, 如何实现高效、安全且智能化的数据访问与查询成为研究热点[2]。然而, 多源异构数据来源分散、格式差异显著, 导致传统局部数据管理系统的应用效果大大降低[3]。
如图1 所示, 针对多源异构数据访问与查询任务, 用户通过输入自定义查询来访问多源异构数据并获取融合后的信息, 其核心在于跨数据源的统一访问。目前, 跨数据源的统一访问研究已实现对多源异构数据的预先集成(即物理融合[4]), 并初步具备在联邦框架下虚拟化查询的能力[5]。物理融合将多源数据整合在单一物理设备上, 并通过结构转换来统一表示异构数据, 处理所需时间成本高, 内存占用大, 且可扩展性差。此外, 在对多源异构数据的融合中通常难以准确地关联不同源描述的同一实体[6]。
图1 面向多源异构数据的查询任务
Fig.1 Query tasks for multi-source heterogeneous data
虚拟知识图谱(virtual knowledge graph, VKG)以及 RDF 分子模板(RDF molecular template, RDF-MT)[7]等技术的迅速发展, 为多源异构数据的访问和查询提供了新的解决方案[6]。这类技术通过数据虚拟化构建数据映射, 允许数据保留在原始数据源中, 并通过统一的查询接口进行底层数据的查询[5]。
RDF-MT 是对 RDF 基础语义的扩展, 通过抽象描述实体类别, 将异构数据映射为虚拟 RDF 图, 实现对多源异构数据的统一表示。此外, 通过将子查询与 RDF-MT 匹配, 可自适应定位数据源, 从而在执行查询时精确地选取对应的数据源。然而, 针对多源异构查询问题, 缺少统一的设定, 也缺少在实际数据上的性能研究, 且实际应用中常见的数据冲突问题容易被忽视。
本文基于 RDF-MT 联邦查询框架, 采用 LSLOD等真实数据集, 研究多源异构查询性能, 探讨数据规模和查询复杂性对查询性能的影响, 并研究RDF-MT 联邦查询框架在数据冲突场景中的应对机制, 探究虚拟化数据访问技术在多源异构数据查询中的发展方向。
在多源异构数据的联邦查询任务中, 数据虚拟化访问、异构数据统一访问以及多源异构数据关联查询这三大核心技术至关重要。数据虚拟化技术将存储与业务逻辑分离, 其架构特性为多源异构数据的独立管理提供了技术基础[8]。在此基础上, 异构数据统一访问机制支持用户以标准化接口融合异构数据, 打破数据结构差异带来的统一访问困难[9]。随着对跨源查询和统一表示的需求日益增长, 如何制定自适应的多源异构数据关联策略[10], 赋予系统自适应数据源定位以及查询结果关联融合的能力,并采用统一的形式返回查询结果, 目前存在较大的技术挑战。
在虚拟方法(如 VKG 技术)中, 数据保留在原始资源中, 用户的访问和查询操作均针对构建的虚拟化全局视图进行, 通过特定的包装器, 实现将全局查询转换为针对数据源的查询[11]。例如, Kurniawan等[12]针对多台主机上的异质数据, 动态地构建虚拟知识图谱, 自下而上地实现对多源异构数据的集成。
基于虚拟化的数据访问架构, 通过映射文件,可实现对多源异构数据的独立查询, 然而无法对底层数据源进行联合查询或自适应关联。
为捕获数据源中的语义信息, 多数研究基于本体的数据访问(OBDA)和数据集成(OBDI)方法[13],实现对底层数据进行统一访问。Morph-RDB[14]主要针对关系型数据库, 基于 R2 RML 映射, 在查询时, 将 SPARQL 查询转为 SQL, 实现对底层数据源的访问与查询; Morph-CSV[15]实现对关系型数据库和 CSV 数据的统一集成。上述两种 Morph 系列工具对 NoSQL 等数据源的支持有限, 因此无法支持对异构数据的统一访问。Ontop[16]基于 RML 映射,根据全局模式, 将查询细化为针对每个数据源的查询, 进而实现对关系型数据以及非关系型数据的访问。与 Ontop 相同, Squerall[17]基于映射, 实现对支持对异构数据的自适应。
上述方法通常需要与数据集成工具联合运用,实现对异构数据的自适应。针对 SPARQL 联合, 通过为每个数据源建立一个单独的 VKG[18], 将它们部署为 SPARQL 端点, 然后将其与 SPARQL Federator 联合。然而, 只有很少的 SPARQL 联合器(例如SemaGrow[19])共享数据的架构信息, 因此很难让用户在制定查询时无需指定端点来回答查询的特定三元组模式, 即在数据源定位上存在极大的困难。
随着数据科学的发展, 数据科学家经常需要从多组织数据湖中查找与当前工作相关的数据, 即按需访问数据源, 因此面向多源异构数据的关联查询至关重要[20]。Zhang 等[21]为解决按需搜索问题, 并整合相关的嵌套数据, 将数据分解为多个基础关系(如 1NF), 以便实现与数据湖内数据源的匹配, 但在寻找相关数据时未充分考虑异构数据。Zhu 等[22]针对多源异构数据按需访问问题, 采用图结构进行统一表示, 并提出线图结构来加速查询线程, 但是并没有考虑复杂的跨数据源联合查询问题。Zhang等[23]提出条件图的概念来解决对异构数据的统一表示, 该方法虽然考虑到未知数据源上的数据访问任务, 但与人工直接定位数据源相比, 在准确性方面表现不佳, 无法做到自适应关联。Endris 等[7,24]提出基于 RDF-MT 的联邦查询框架 Ontario, 将多 源异构数据抽象为一系列 RDF-MT, 进而虚拟化集成在知识图谱上。与 Fedx 和 Ontop 等工作相比, 基于 RDF-MT 的 Ontario 框架可实现自适应查询定位和查询结果关联融合, 在现有多源异构数据的联邦查询任务中较为成熟。
本文选用基于 RDF-MT 的联邦查询框架 Ontario[24]。针对给定的存在一定未知链接的多源异构数据集, 首先基于 RDF-MT 技术构建虚拟化的全局视图, 随后针对用户自定义编写的 SPARQL 进行全局查询, 结合虚拟化全局视图, 实现自适应查询定位和访问。
图2 展示基于 RDF-MT 的查询视图构建流程,该模块旨在提取多源异构数据中的 RDF-MT 及其链接关系, 构建虚拟化的全局视图, 最终得到一个JSON 配置文件, 存储输出的虚拟化全局视图, 通过全局映射, 实现与底层数据源的对应。
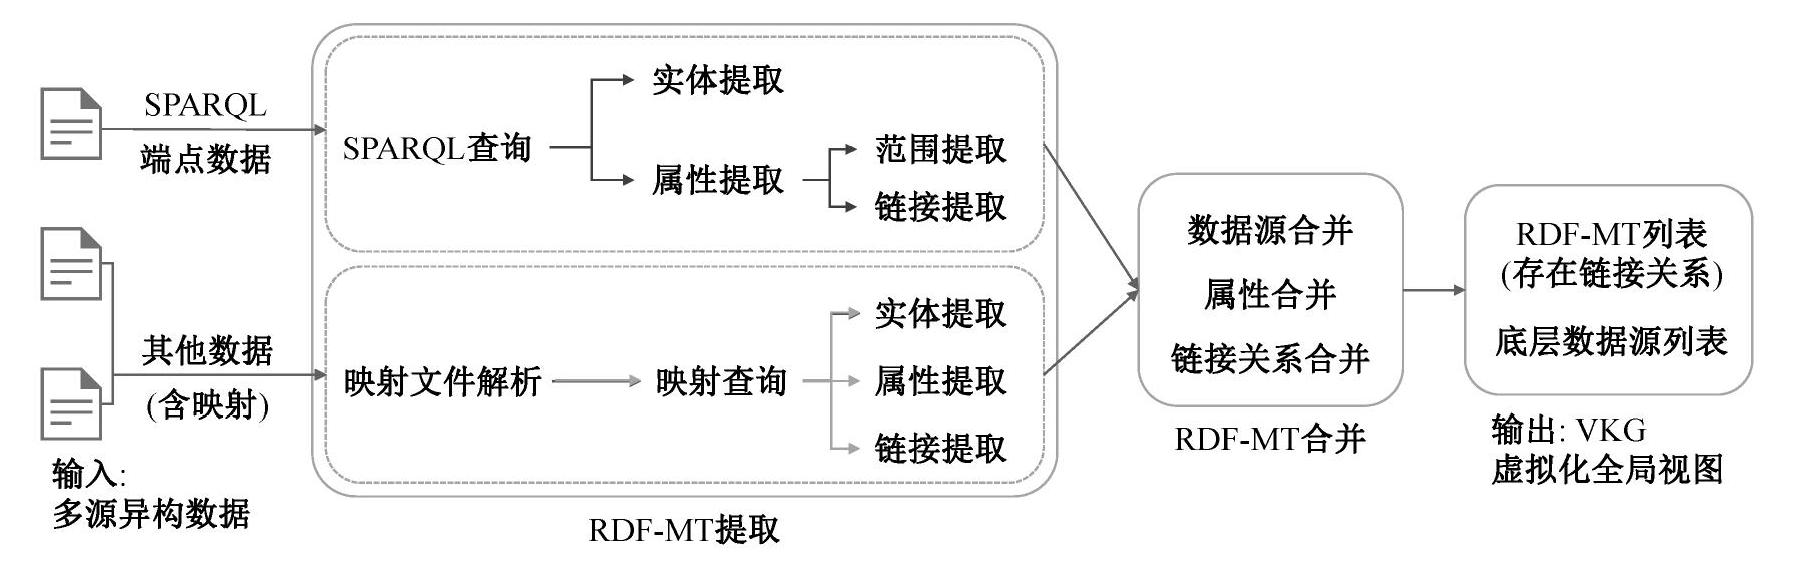
图2 基于 RDF-MT 的全局查询视图构建流程
Fig.2 Construction process of global query view based on RDF-MT
该模型采用 SPARQL 语言作为全局查询机制。SPARQL 端点类数据采用 RDF 三元组格式进行存储, 可直接采用 SPARQL 语言进行查询。MYSQL和 TSV 等非 SPARQL 端点类数据不可以直接执行SPARQL 查询, 而是采用自定义的 R2RML 和 RML映射规则, 经映射转换后再进行查询。本文采用不同方式, 在 SPARQL 端点类数据和非 SPARQL端点类数据中提取 RDF-MT。
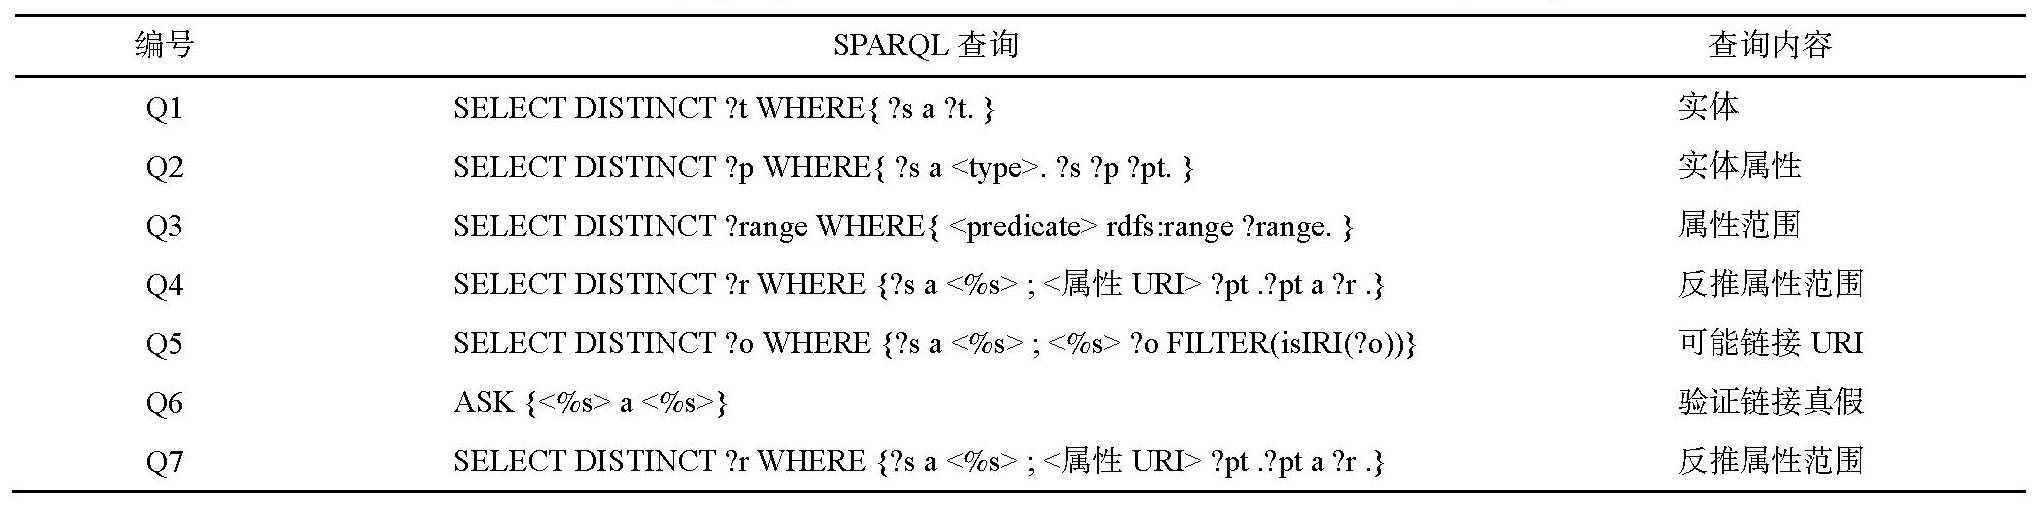
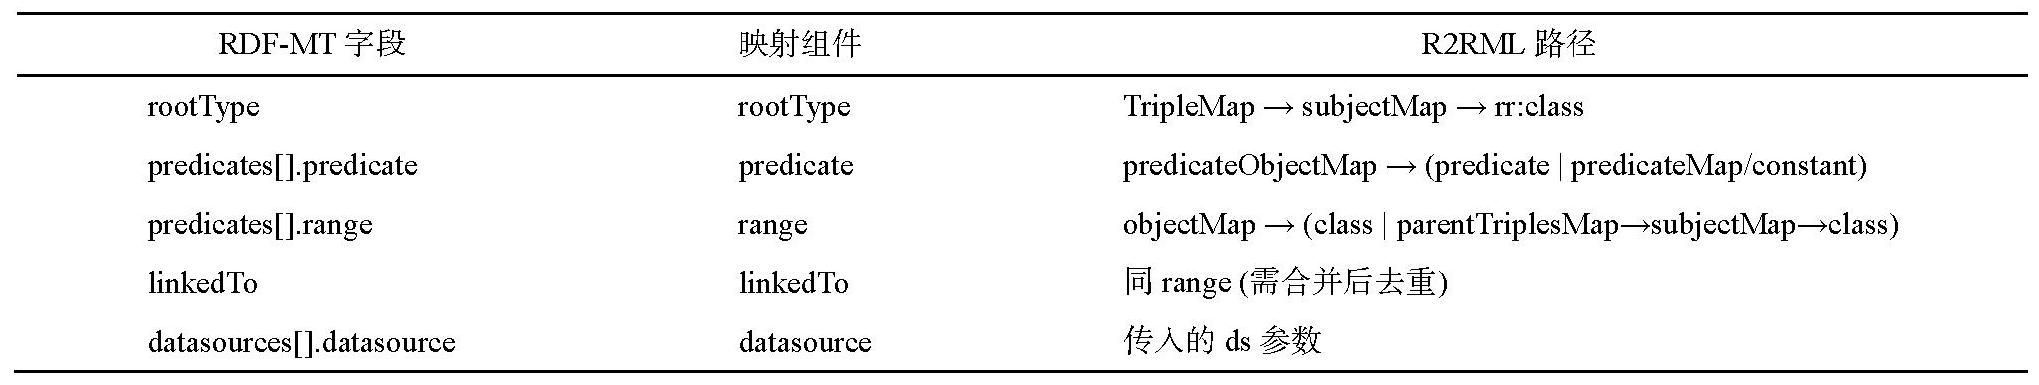
本文针对 SPARQL 端点类型数据, 采用特定的SPARQL 查询(表1)访问 SPARQL 端点, 实现对实体和属性等信息的获取。针对非 SPARQL 端点类型数据, 采用多段式 SPARQL 查询, 由主语、谓词和宾语映射查询构成, 可从特定路径提取主语、谓词和宾语等信息, 根据表2 所示的字段对应关系得到 RDF-MT。映射的正确编写是实现RDF-MT 提取的关键, 所以对映射进行语法和路径的有效性验证,一旦检测到错误(如缺失主语映射、无效谓词路径或文件语法错误), 系统会立即终止视图的构建, 并且抛出明确的异常信息, 提示用户检查并修正映射文件。
表1 SPARQL 端点内部数据获取所需 SPARQL 查询
Table1 SPARQL query needed to fetch internal data from a SPARQL endpoint
编号 SPARQL查询 查询内容Q1 SELECT DISTINCT ?t WHERE{ ?s a ?t. } 实体Q2 SELECT DISTINCT ?p WHERE{ ?s a <type>. ?s ?p ?pt. } 实体属性Q3 SELECT DISTINCT ?range WHERE{ <predicate> rdfs:range ?range. } 属性范围Q4 SELECT DISTINCT ?r WHERE {?s a <%s> ; <属性URI> ?pt .?pt a ?r .} 反推属性范围Q5 SELECT DISTINCT ?o WHERE {?s a <%s> ; <%s> ?o FILTER(isIRI(?o))} 可能链接URI Q6 ASK {<%s> a <%s>} 验证链接真假Q7 SELECT DISTINCT ?r WHERE {?s a <%s> ; <属性URI> ?pt .?pt a ?r .} 反推属性范围
表2 映射文件与 RDF-MT 字段的对应关系
Table2 Mapping relationship between configuration files and RDF-MT fields
RDF-MT字段 映射组件 R2RML路径rootType rootType TripleMap → subjectMap → rr:class predicates[].predicate predicate predicateObjectMap → (predicate | predicateMap/constant)predicates[].range range objectMap → (class | parentTriplesMap→subjectMap→class)linkedTo linkedTo 同range (需合并后去重)datasources[].datasource datasource 传入的ds参数
图3 展示基于虚拟化全局视图的联邦查询流程,包括查询解析、物理计划生成和查询执行 3 个模块。在多源异构查询场景下, 面临数据定位困难、计划评估复杂和结果聚合分散的挑战, 该模型分别通过 RDF-MT 定位、动态连接策略选择以及基于映射规则的值统一化来解决上述问题。
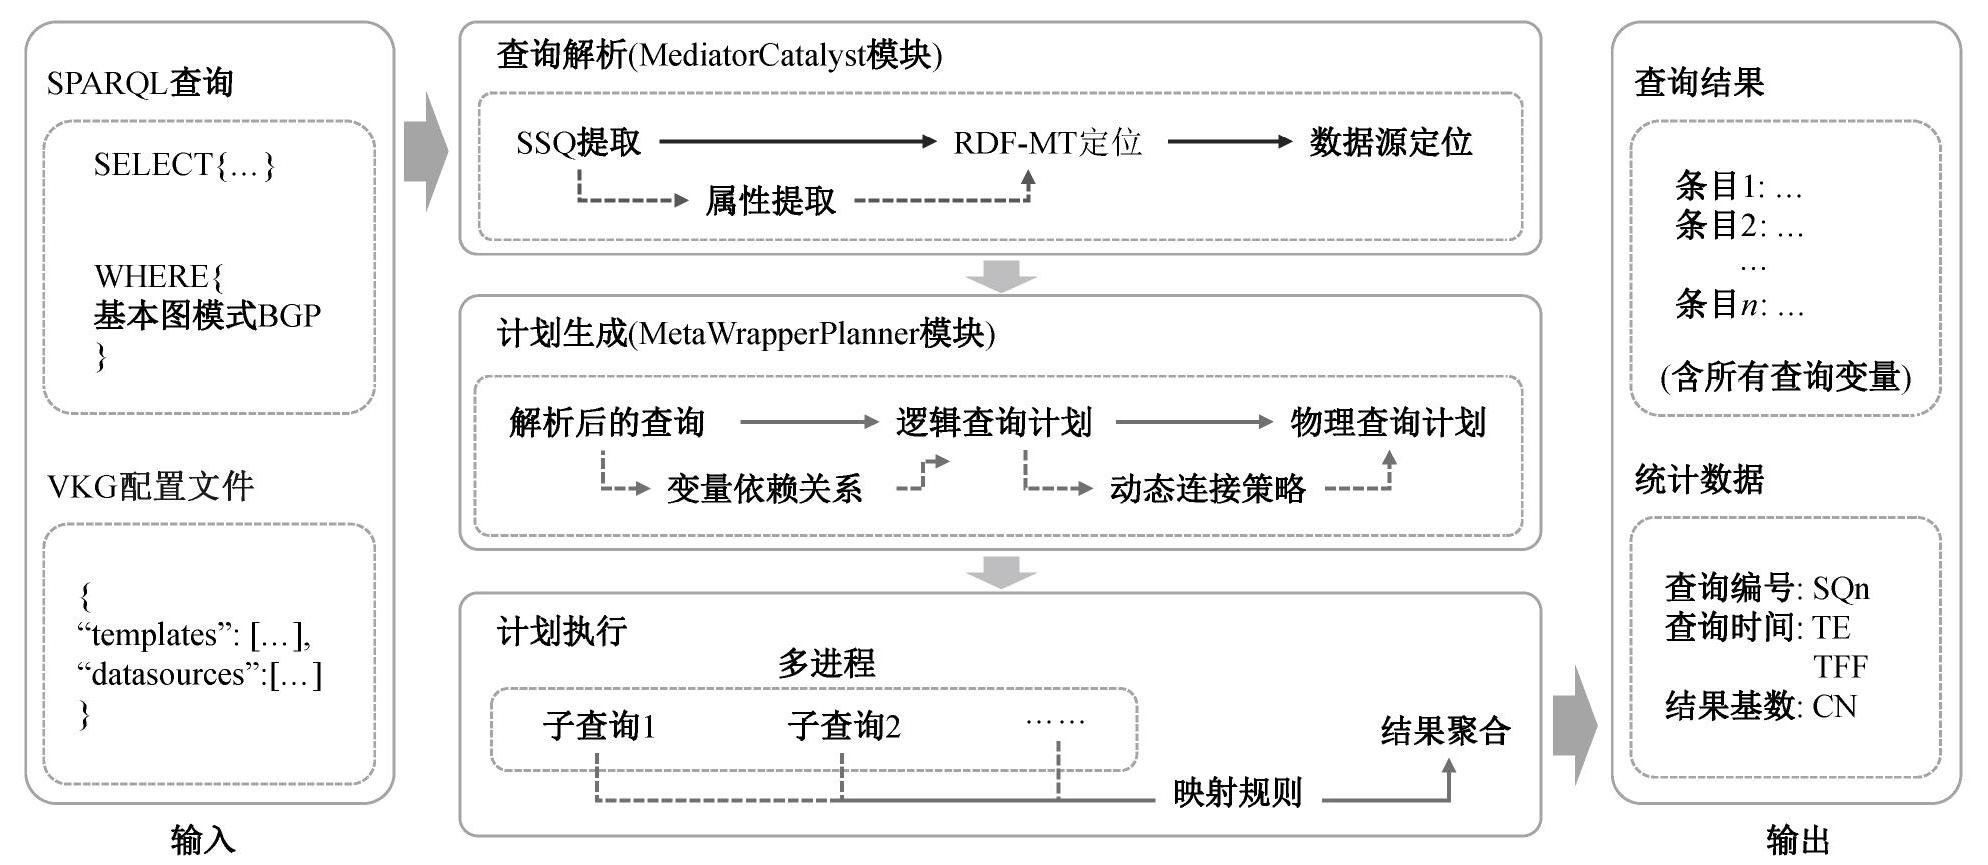
图3 基于虚拟化全局视图的联邦查询流程
Fig.3 Federated query process based on virtualized global view
2.2.1 查询解析
针对所有三元组, 将相同主语的三元组归并为星型子查询, 并采用双重判定策略来匹配 RDF-MT及底层数据源。针对星型模式, 首先判断其是否包含显式的 rdf:type 声明, 若是, 则直接关联对应类型的 RDF-MT, 否则用基于谓词覆盖率的计算进行匹配, 最终选择覆盖率最高的 RDF-MT。该过程中可能产生多个 RDF-MT 候选, 在后续计划生成阶段会对其进行优化和筛选。若 RDF-MT 未能成功匹配,则模型会在后续查询执行中为该部分返回空结果集, 整个查询进程将继续执行其他可成功匹配的子查询。
基于全局查询和全局视图, 提取星型子查询间的变量连接以及 RDF-MT 间的语义连接。为优化RDF-MT 匹配, 基于连接一致性原则, 对 RDF-MT进行剪枝, 剔除冗余模板。若星型模式 A 通过谓词p 连接到 B, 但 A 的某个 RDF-MT 不支持 p 的定义域(或值域)约束, 则将该模板剔除。
2.2.2 计划生成
采用自顶向下的递归策略, 根据星型子查询生成局部连接计划, 构建多路连接树来规避线性连接的性能陷阱。根据对应关系(表3), 可将逻辑计划树转换为物理计划树。
表3 物理操作符
Table3 Physical operator
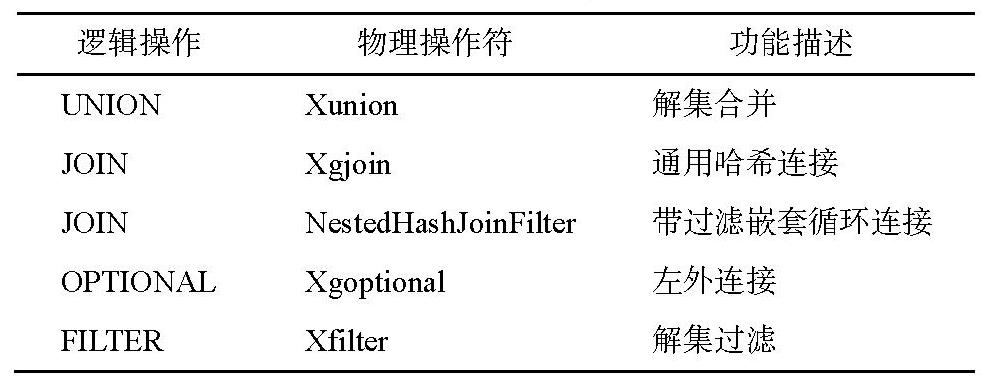
逻辑操作 物理操作符 功能描述 UNION Xunion 解集合并 JOIN Xgjoin 通用哈希连接 JOIN NestedHashJoinFilter 带过滤嵌套循环连接 OPTIONAL Xgoptional 左外连接 FILTER Xfilter 解集过滤
基于数据源类型和选择性评估动态选择连接算法, 优先采用高选择性连接策略, 以便优化查询执行效果, 选择性判定的计算公式如下:

其中, triple.constants 和 triple.variables 分别表示三元组模式中常量和变量元素的数量, threshold 表示选择性判定阈值。通过量化三元组模式的约束强度来优化连接顺序, 优先执行高选择性操作, 从而减少后续操作的数据量, 以便节省资源, 提升模型的 性能。
2.2.3 计划执行
按照自底向上的顺序, 对物理查询计划中的复 合操作节点和叶子节点执行查询操作。针对 Node-Operator 复合操作节点, 模型为左右子树和操作符创建多线程并行执行, 对结果统一处理后输出。针对 LeafOperator 叶子节点, 模型基于所需访问的数据源类型选择包装器, 将全局查询机制 SPARQ 转换为底层查询机制, 实现统一访问; 随后结合映射规则, 将底层数据转为 RDF 格式, 实现统一表示。
本文实验中使用生命科学领域的公开数据集LSLOD[25], 包含一个主题的数据被单独存储在一个文件内。将 MySQL 数据 Drugbank、SPARQL 端点类数据 KEGG 和 TSV 数据 ChEBI 作为多源异构数据集。
面向该多源异构数据集, 采用 Ontario 框架进行实例分析。首先利用该框架构建基于 RDF-MT 的虚拟化全局视图, 并将其存储为 config1.json 文件。RDF-MT 及其链接关系如表4 所示。
表4 VKG 中 RDF-MT 及其链接关系
Table4 RDF-MT and its linkage relationships in virtual knowledge graph
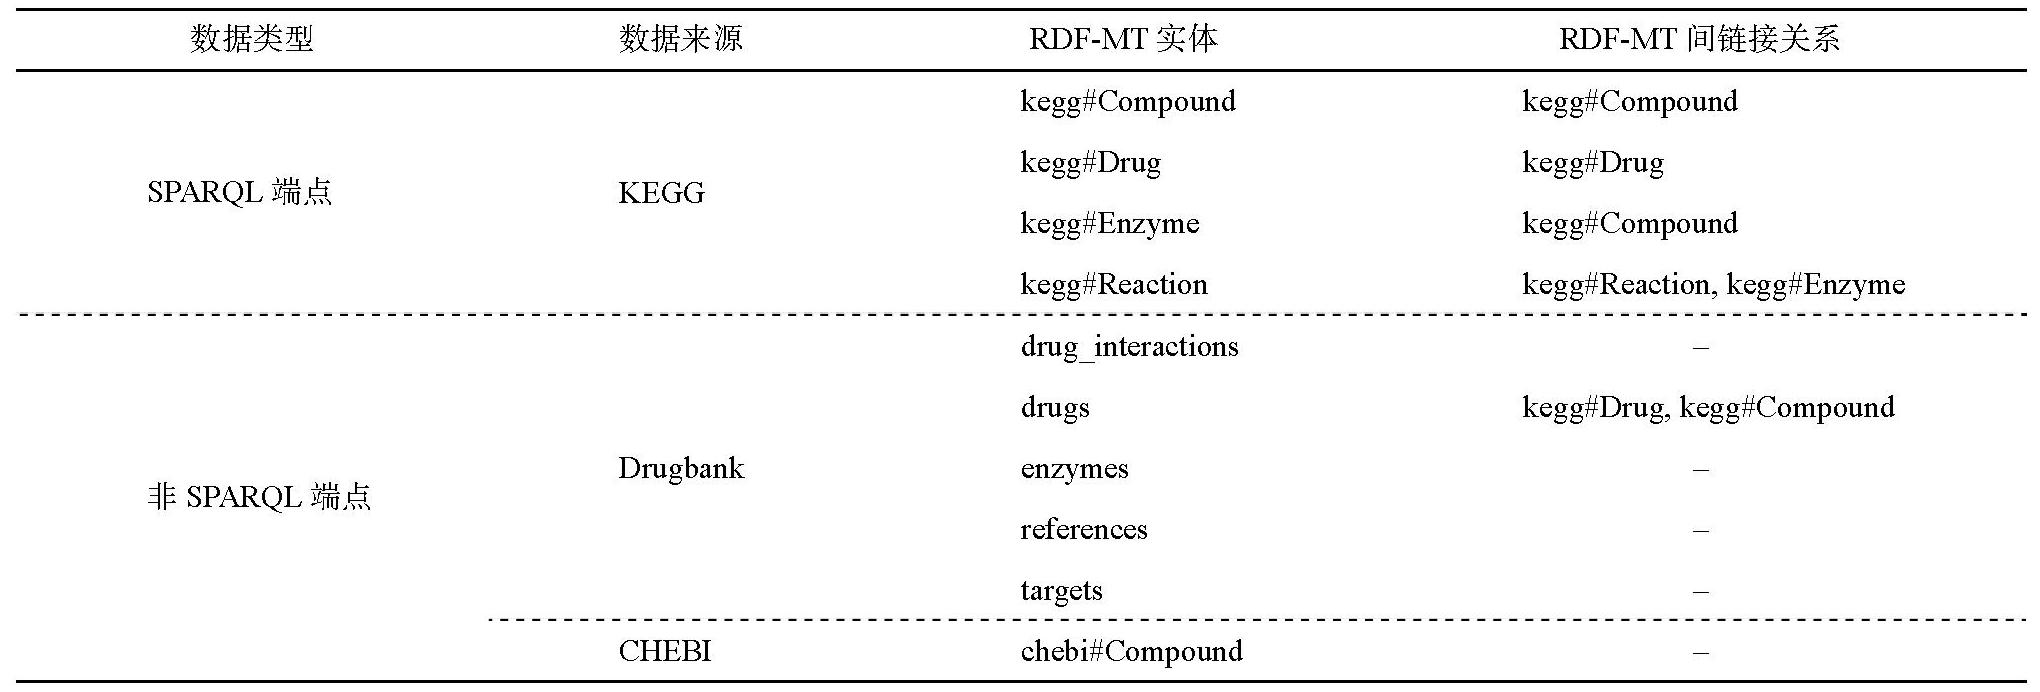
数据类型 数据来源 RDF-MT实体 RDF-MT间链接关系kegg#Compound kegg#Compound SPARQL端点 KEGG kegg#Drug kegg#Drug kegg#Enzyme kegg#Compound kegg#Reaction kegg#Reaction, kegg#Enzyme drug_interactions -drugs kegg#Drug, kegg#Compound 非SPARQL端点Drugbank enzymes -references -targets -CHEBI chebi#Compound -
为验证 RDF-MT 技术在联邦查询任务中能否根据全局视图实现对未知底层数据源的全局SPARQL查询的自适应数据源定位、查询结果的关联融合和统一表示, 本文采用跨多数据源的简单联邦查询数据集 SQ2 进行实验。如图4 所示, SQ2 包含 6 个 RDF三元组查询语句。
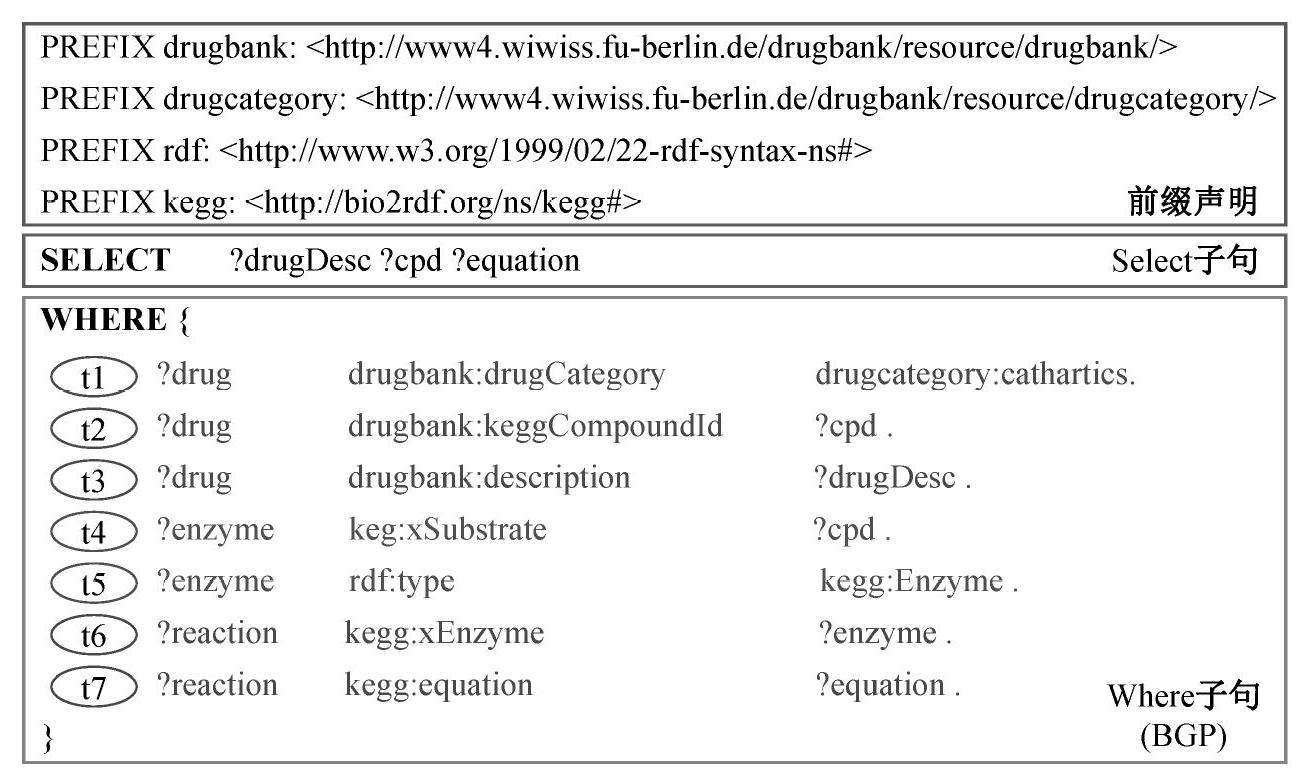
图4 跨多源异构数据的联邦查询
Fig.4 Federated query across multi-source heterogeneous data
在查询解析阶段, 对分解得到的一系列星型子查询匹配 RDF-MT, 进而实现自适应定位底层数据源。如图5 所示, 该模型可对 SQ2 进行主语聚类,得到 drug, keggDrug 和 chebiDrug 三个星型子查询,并基于谓词覆盖度为其分别匹配, 得到 drug-bank: drugs, keggCompound/Drug 和 chebi:Compound 三个RDF-MT, 进而定位到底层数据源。
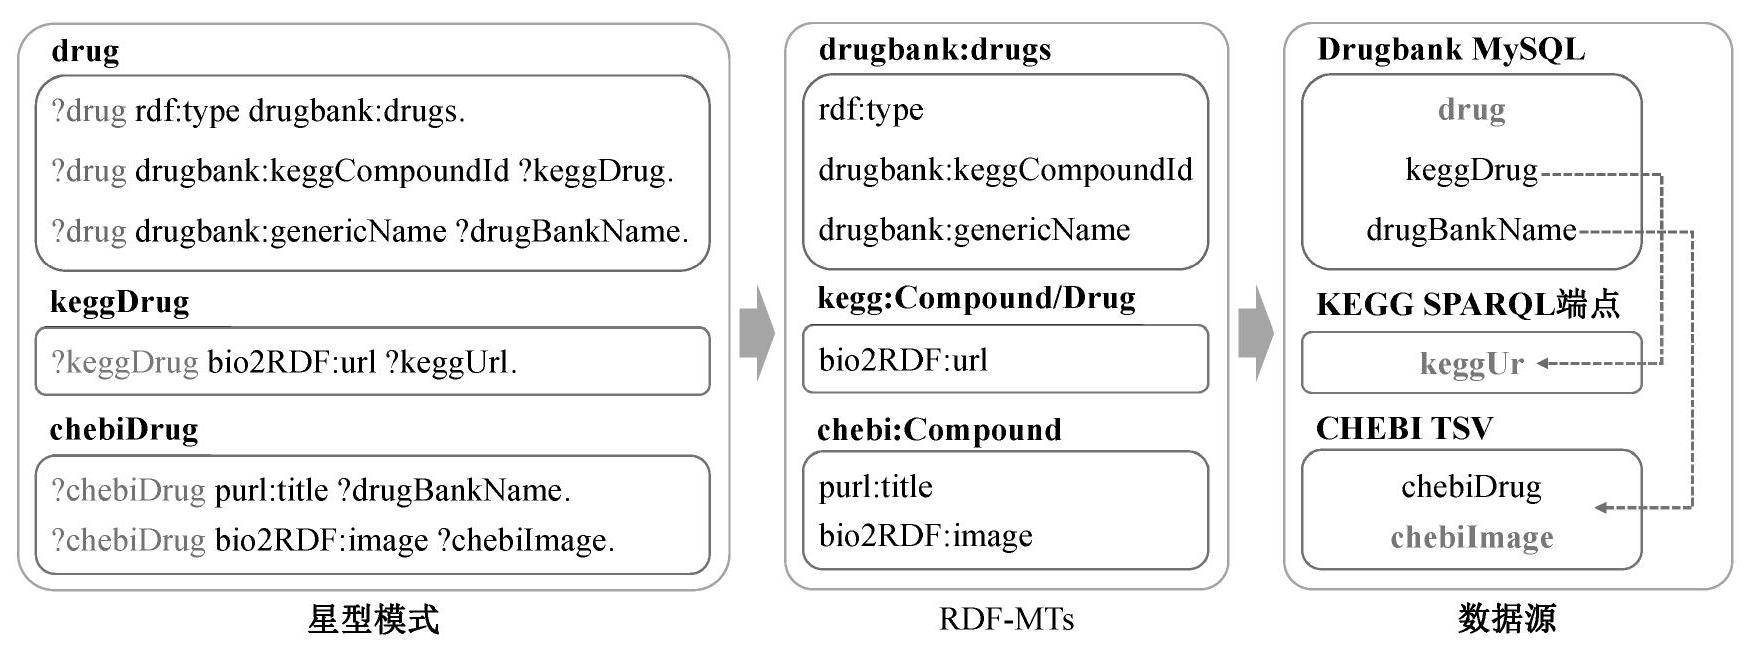
图5 SQ2 查询解析结果
Fig.5 Query parsing result of SQ2
除 RDF-MT 匹配外, 查询解析阶段还会提取到数据源间变量的连接关系, 辅助第二阶段的计划生成。如图6 所示, 该联邦查询框架可指导模型按需访问数据源, 按计划获取相关变量信息后进行融合输出。
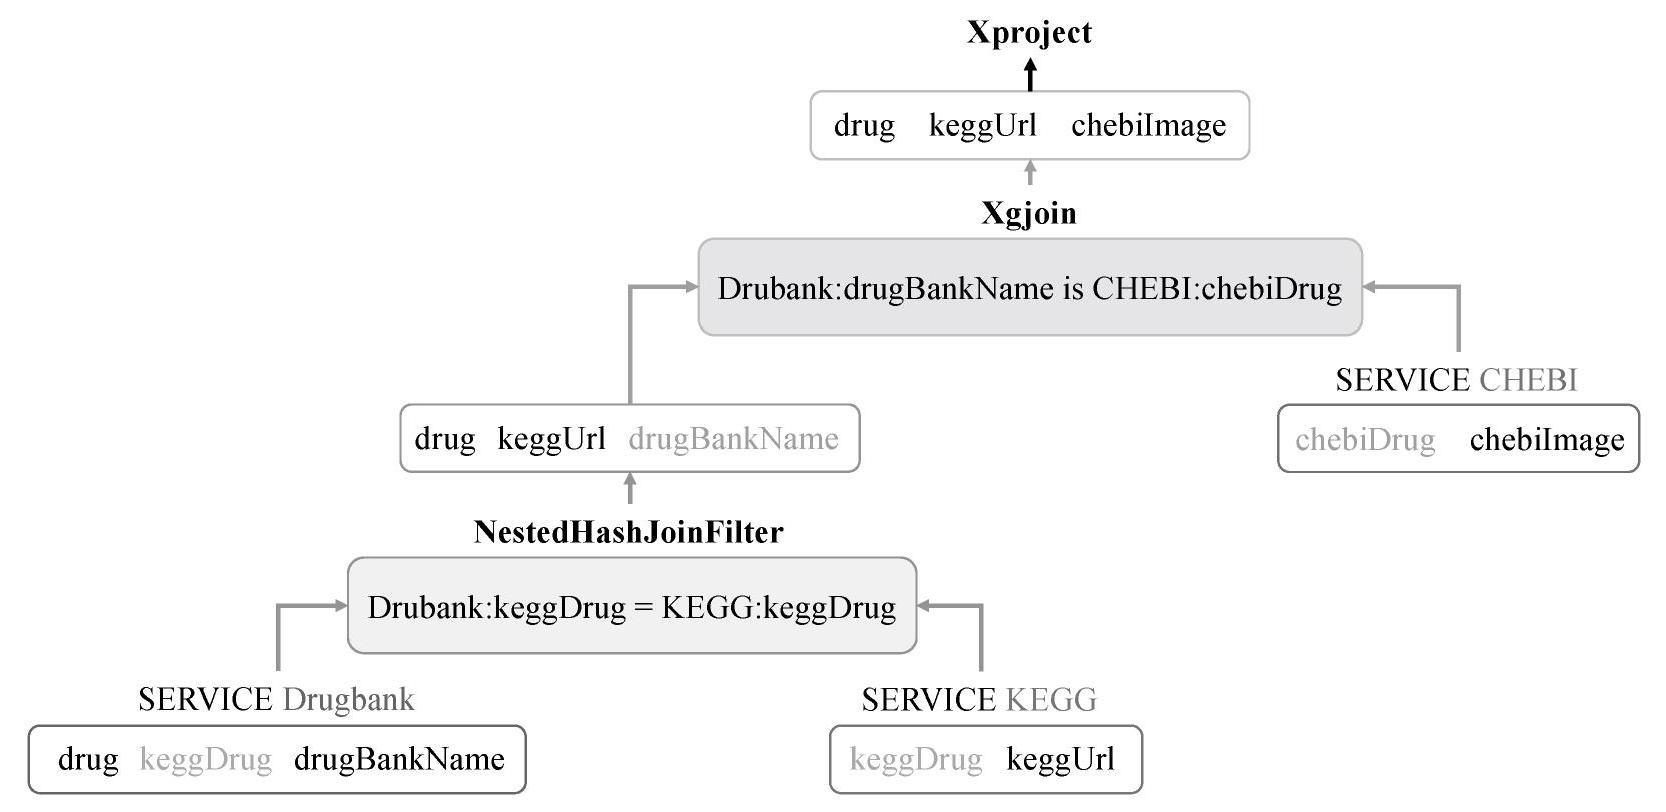
图6 SQ2 物理计划树
Fig.6 Physical plan tree of SQ2
为探究模型稳定性和高效性, 将原有 TSV 数据集进行拆分, 得到数据规模分别为 10170, 30139 和50477 的 CHEBI1, CHEBI2 和 CHEBI0 数据集, 探究不同规模数据集对模型性能的影响。
本实验采用查询解析用时(TD)、计划生成用时(TP)、响应用时(TFF)和吞吐量(dief@t)等指标来衡量模型的性能。吞吐量用于衡量查询引擎在时间窗口 t 内持续返回结果的效率, 反映模型逐步生成结果的速度和稳定性:

其中, Cardinality 表示查询获得的结果基数, Execution Time 表示查询执行总用时。
从图7 可以看出, 随着数据规模增大, 查询解析用时和计划生成用时趋同, 没有明显的变化; 吞吐量明显上升, 表明模型对小规模数据的适应度高。解析结果的稳定性和吞吐量的增长趋势证明模型具有扩展潜力。
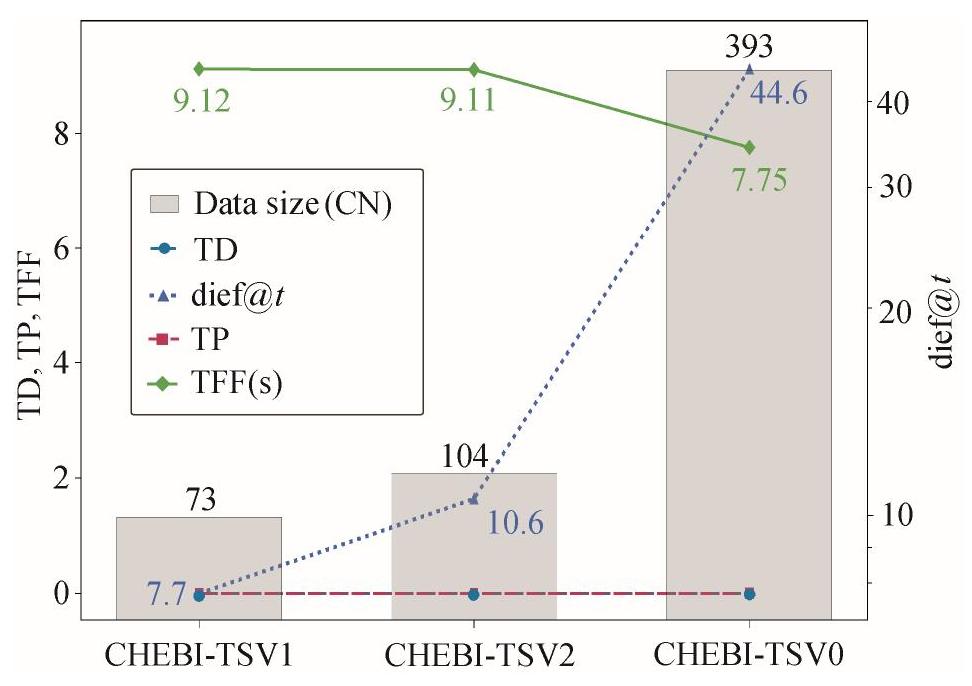
图7 数据规模对查询效率的影响
Fig.7 Impact of data scale on query efficiency
为进一步探讨模型对复杂查询的适应性, 选用变量数和跨源数等存在差异的查询集(表5) 进行对比实验。
表5 查询集
Table5 Query set
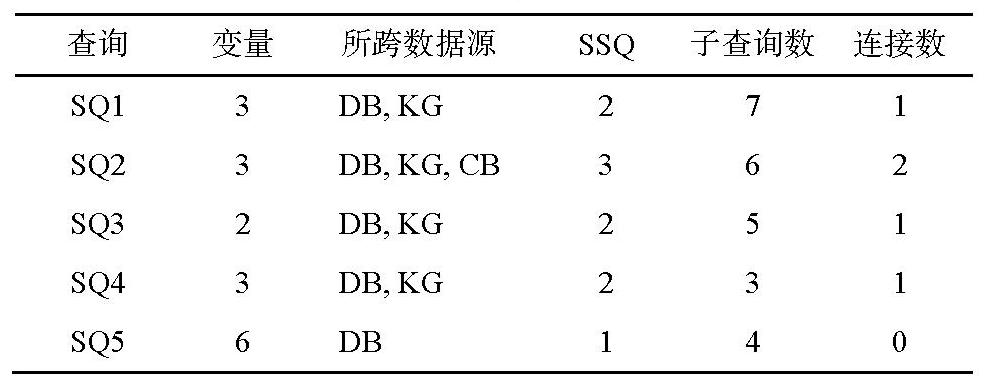
查询 变量 所跨数据源 SSQ 子查询数连接数SQ1 3 DB, KG 2 7 1 SQ2 3 DB, KG, CB 3 6 2 SQ3 2 DB, KG 2 5 1 SQ4 3 DB, KG 2 3 1 SQ5 6 DB 1 4 0
说明: DB, KG 和 CB 分别代表Drug-bank, KEGG 和 CHEBI 数 据集。
如图8 所示, 查询复杂度对查询解析用时和计划生成用时的影响不大。查询响应用时存在跨源惩罚效应, 其中 SQ5 不涉及跨源查询, 平均响应用时为 0.04 s; SQ2 涉及跨三源的联邦查询, 平均响应用时为 8.66 s; 其余查询均涉及跨两源的联邦查询, 平均响应用时为 0.10~0.20 s; 跨源查询显著影响模型响应性能和模型连续效率。此外, 在相同跨源条件下, 减少子查询数量可减少 20%~30%的吞吐量。与传统的基于本体的数据访问框架(如 Ontop)相比,处理单个查询的时间约为 0.5 s, 基于 RDF-MT 的联邦处理框架在查询效率上具有显著优势。
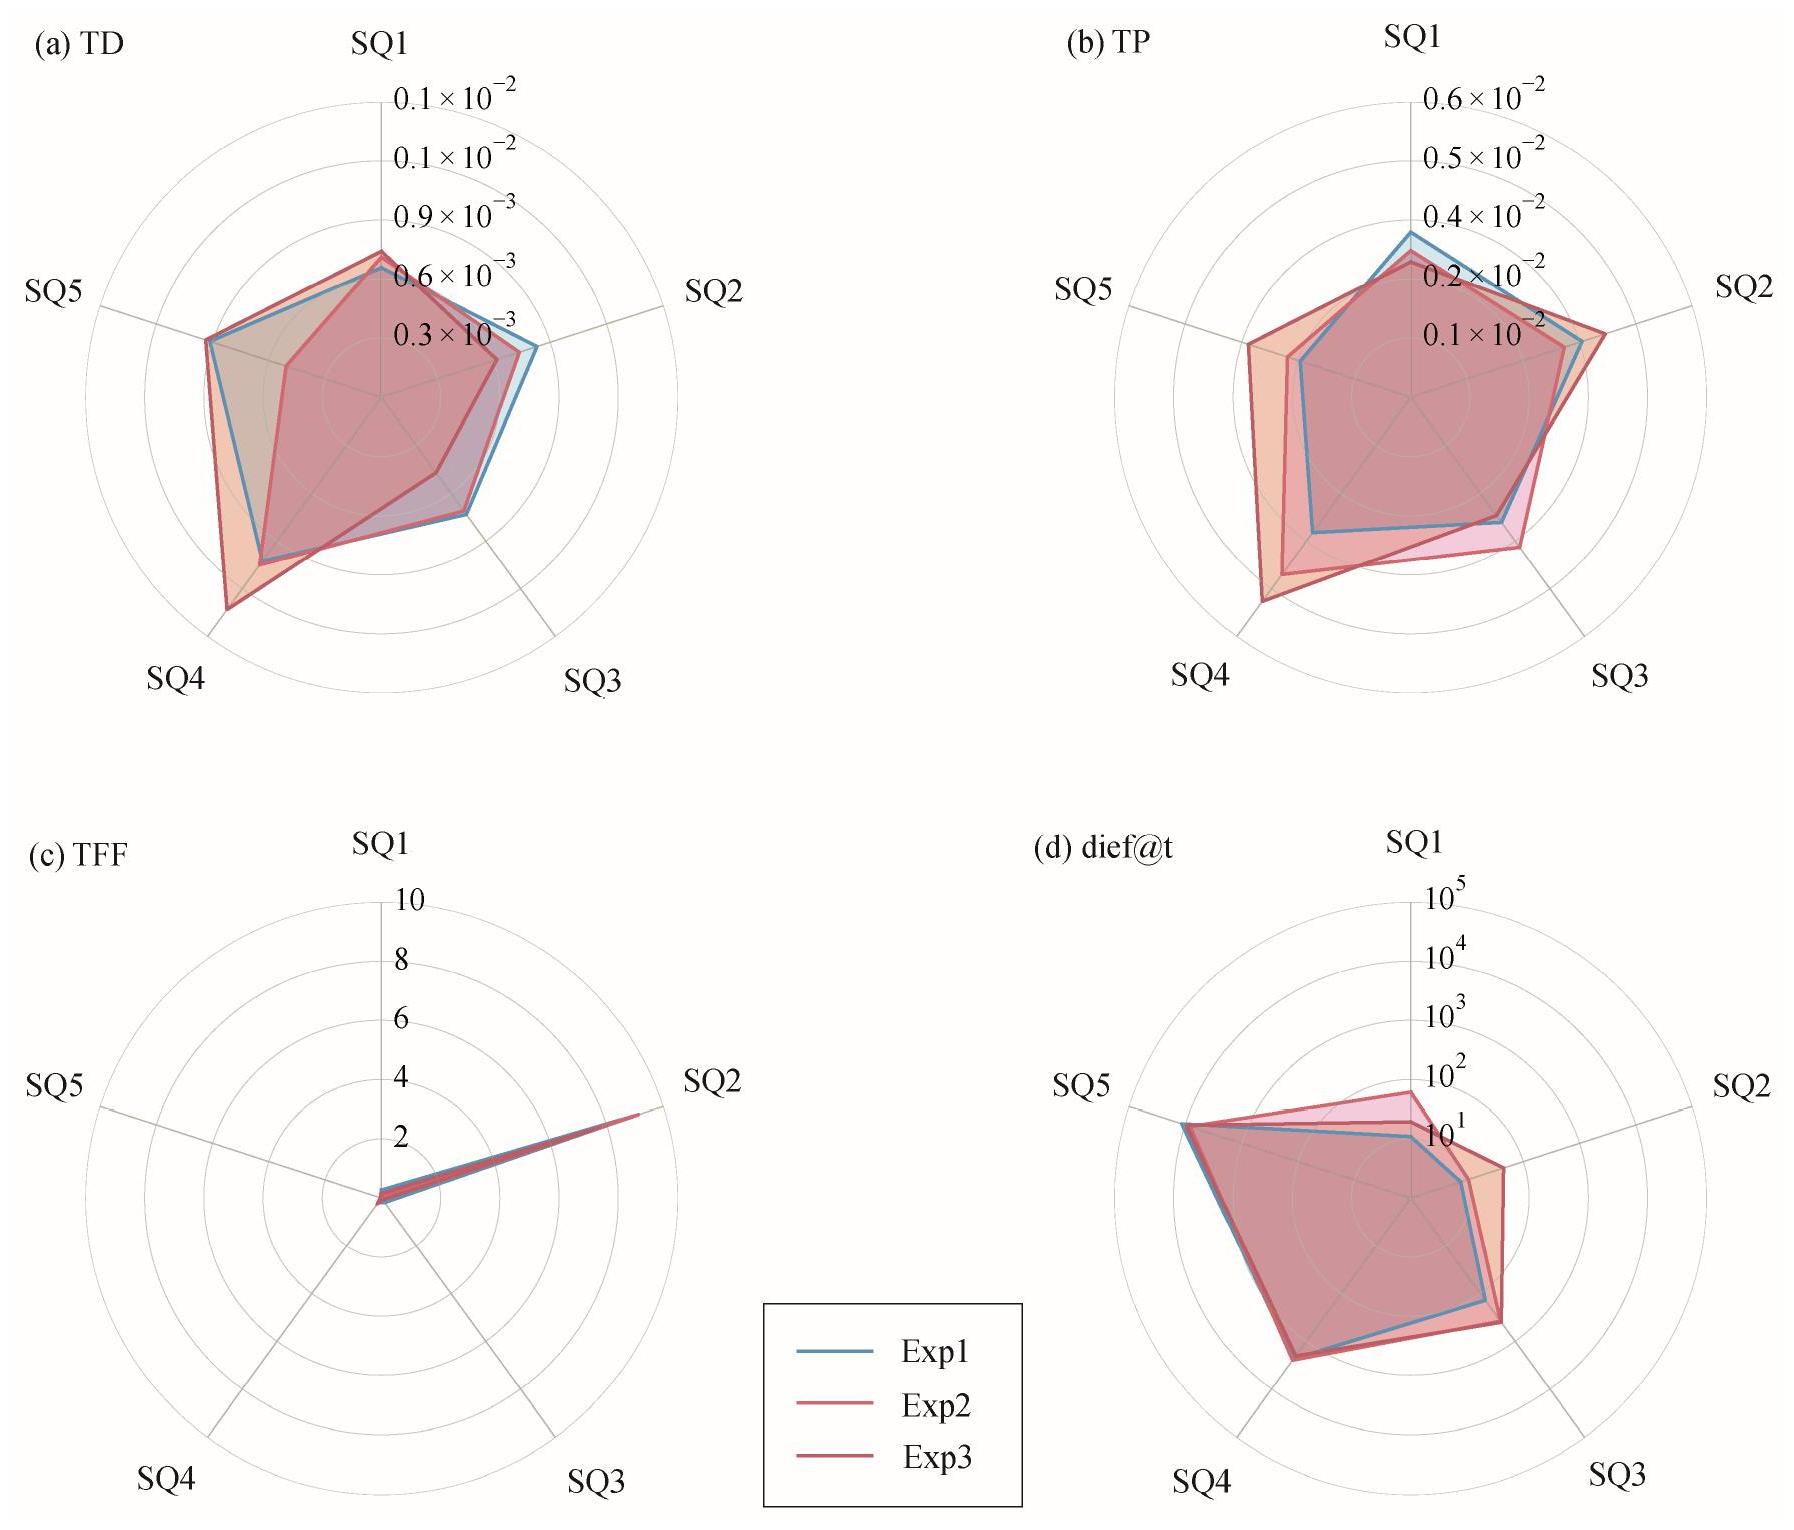
图8 执行查询集的评估结果对比
Fig.8 Comparison of evaluation results for executing query set
本实验针对实体冲突场景, 假设原始多源异构数据集中存在来源不同但主题相同的数据, 探究基于 RDF-MT 技术的联邦查询框架在视图构建以及查询执行阶段对此类扩展的适应性。将原有 CHEBI 数据集划分为两部分, 得到新的数据集 CHEBI3 以及 CHEBI4。
3.4.1 全局视图构建阶段
针对新的多源异构数据集, 基于 RDF-MT 得到新的虚拟化全局视图, 存储为 config2.json。与 config1.json 相比, config2.json 的不同之处在于原有来自 CHEBI 的 chebi#Compound 实体被来自 CHEBI3的 chebi3#Compound 实体和来自 CHEBI4 的 chebi4#Compound 实体替代, 即该模型基于命名空间隔离,实现对来源不同但语义相同实体的标识。针对不同数据源, 在映射文件编写阶段, 模型基于数据源命名扩展得到实体 URI, 即来源不同的同一实体, 其命名是不同的。在映射解析阶段, 模型严格保留R2 RML 和 RML 映射文件中的 URI, 进行原生解析,不进行 URI 规范。在 RDF-MT 合并阶段, 当且仅当根类型 URI 完全一致时, 方可进行模板合并, 故此类冲突会被认为是不同的 RDF-MT 而被保留。
3.4.2 计划执行阶段
如图9 所示, 由于虚拟化全局视图为 CHEBI3和 CHEBI4 中的 Compound 分别创建了不同的 RDF-MT 模板, 故星型模式 chebiDrug 会匹配到 chebi3: Compound 和 chebi4:Compound 两个 RDF-MT, 进而访问到 CHEBI3 和 CHEBI4 数据源, 即星型子查询会同时匹配到语义相同的 RDF-MT。
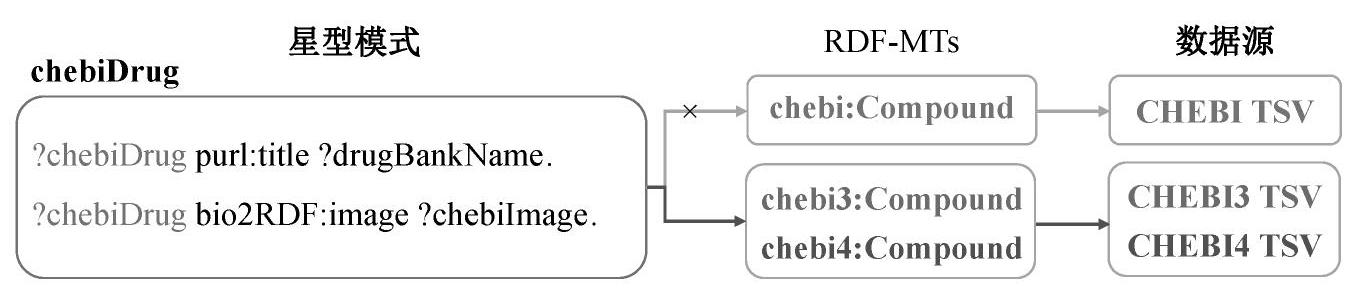
图9 实体冲突下的查询解析结果
Fig.9 Query parsing results under entity conflicts
在计划生成阶段(图10), 模型采用 Xunion 操作, 对从冲突实体对应的数据源中得到的子查询结果首先执行操作, 然后传递给其他操作节点。本模型可将冲突实体数据视为互相的实例补充, 在查询过程中会将两个数据集先进行合并, 再执行其他连接操作。
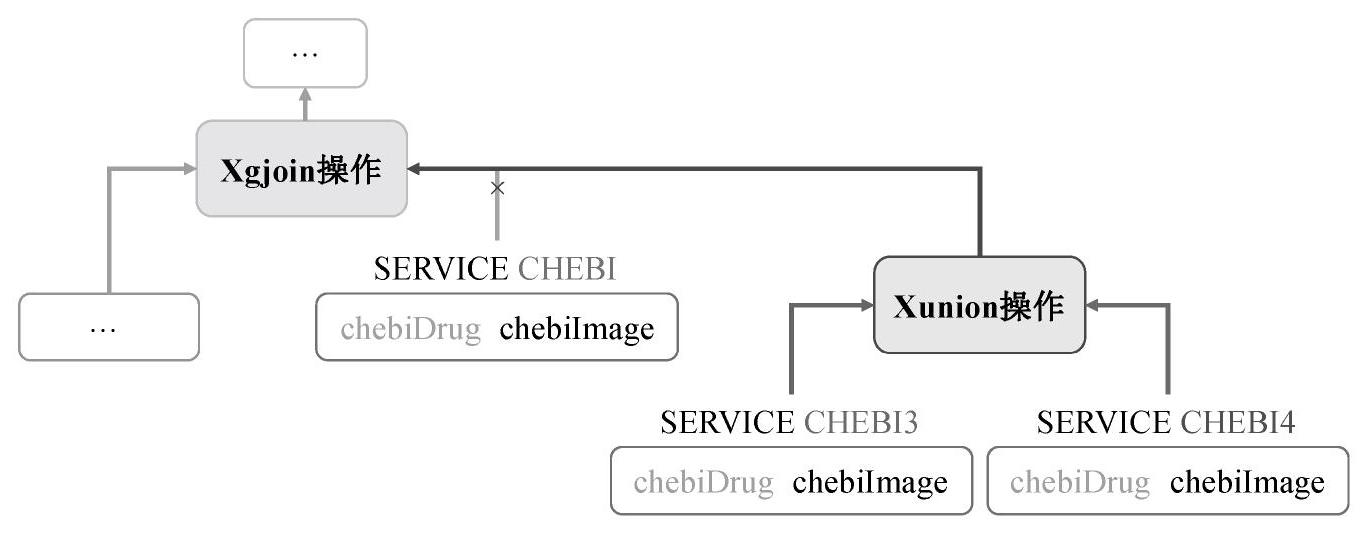
图10 实体冲突下的物理计划
Fig.10 Physical plan under entity conflicts
为了进一步探究此执行策略的性能, 采用不同的数据集和虚拟化全局视图进行实验, 实验设置见表6。
表6 Xunion 操作验证实验数据集
Table6 Experimental dataset for Xunion operation verification
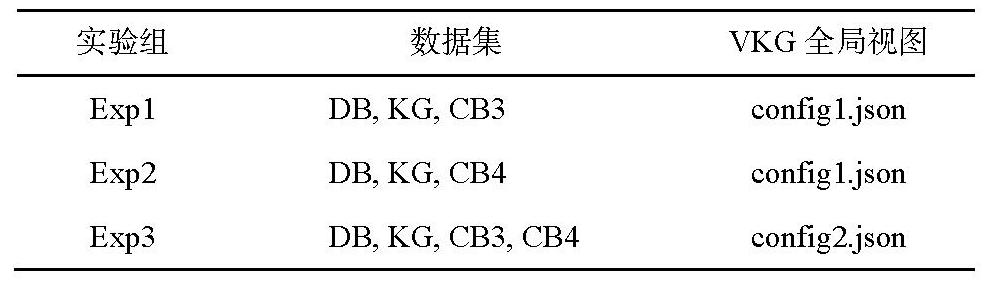
实验组 数据集 VKG全局视图 Exp1 DB, KG, CB3 config1.json Exp2 DB, KG, CB4 config1.json Exp3 DB, KG, CB3, CB4 config2.json
如图11 所示, Exp3 得到的结果基数为 Exp1 与Exp2 之和, 证明 Xunion 操作的可行性。此外, Exp 3的执行时间远小于 Exp1 与 Exp2 之和, 因此证明该模型面对冲突时具有良好的适应性, 采用 Xunion 操作应对冲突具有明显的时间成本优势。
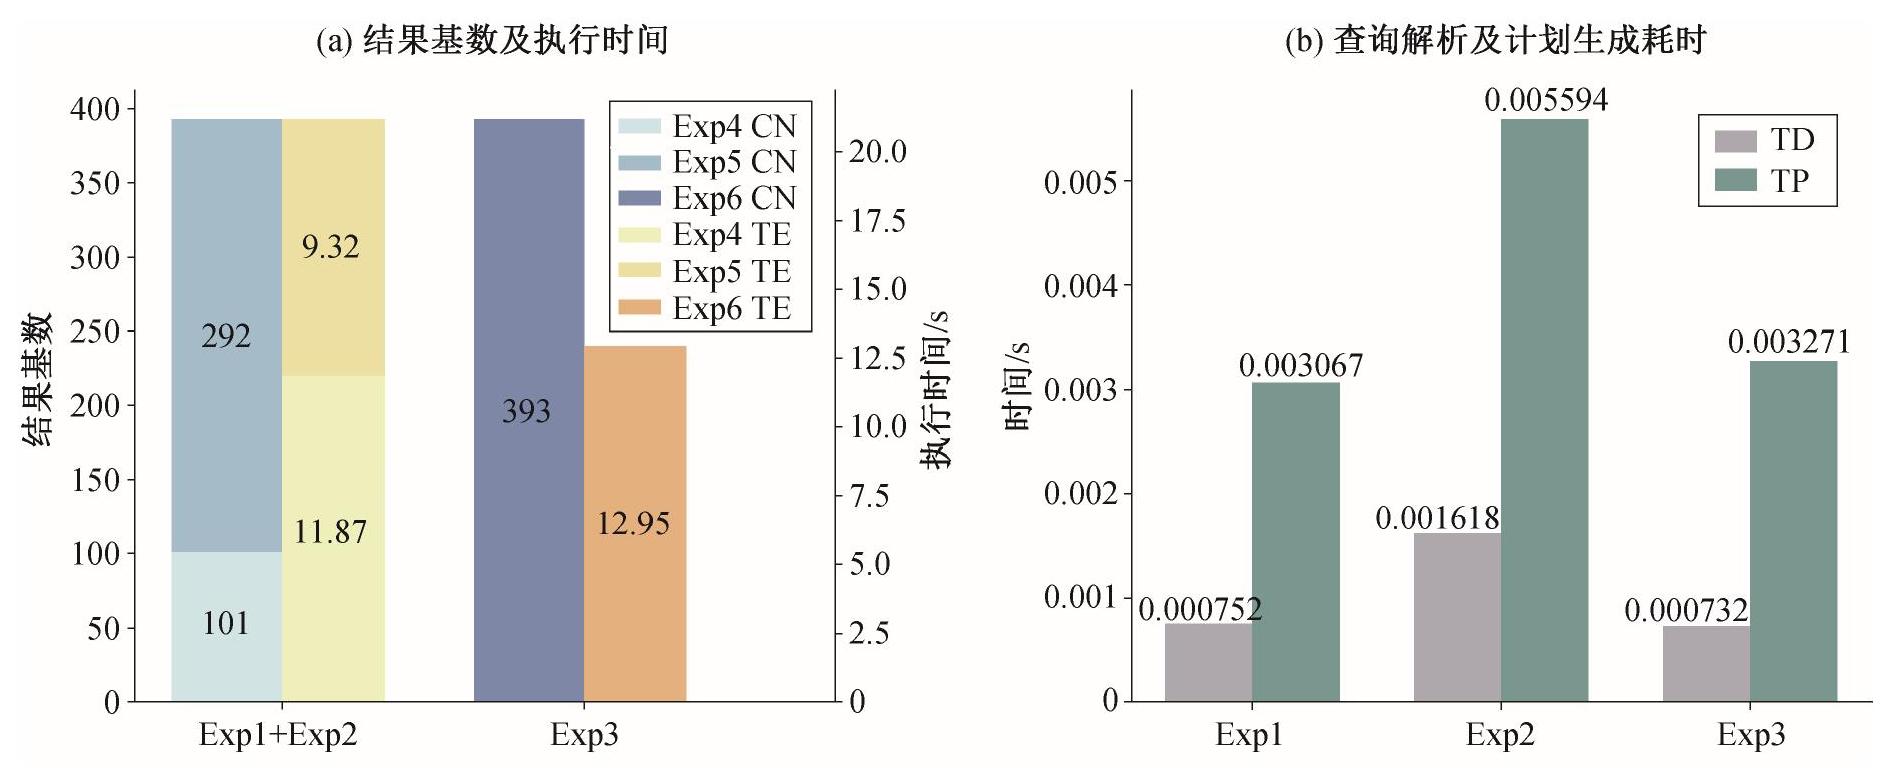
图11 模型对数据源扩展的适应性研究
Fig.11 Research on the adaptability of the model to data source expansion
本文围绕多源异构场景下 RDF-MT 技术在查询任务中的表现, 通过实质性实验, 探究基于 RDF-MT 的联邦查询框架的性能, 并分析此框架对实际存在的数据冲突问题的应对机制。实验结果表明,RDF-MT 技术可实现对多源异构数据的虚拟化跨源查询和统一表示, 能很好地适应数据规模的增大,但模型的连续性会随所跨数据源数的增加而减小。此外, 基于 RDF-MT 技术, 通过命名空间隔离, 可有效地区分来源不同但语义相同的数据, 在计划执行阶段, 对匹配到的多个底层数据源采用先合并后连接策略, 可避免冲突数据对查询进程的影响, 具有明显的优势。总而言之, RDF-MT 技术在多源异构数据查询任务中具有极大的应用潜力, 未来应持续优化模型, 降低模型使用的技术门槛, 进一步提升模型的性能, 以期在更大规模的数据集和更复杂的数据源环境下验证框架的性能, 进而将本文优化策略适配于企业级应用场景。
[1] 王一楠. 大数据时代企业经营管理模式的优化研究.全国流通经济, 2024(22): 94-97
[2] 梁秀波, 吴俊涵, 赵昱, 等. 区块链数据安全管理和隐私保护技术研究综述. 浙江大学学报(工学版),2022, 56(1): 1-15
[3] 闫佳和, 李红辉, 马英, 等. 多源异构数据融合关键技术与政务大数据治理体系. 计算机科学, 2024,51(2): 1-14
[4] 余辉, 梁镇涛, 鄢宇晨. 多来源多模态数据融合与集成研究进展. 情报理论与实践, 2020, 43(11): 169-178
[5] 卢加荣, 廖彬, 刘怡, 等. 融合多源异构数据的ICO欺诈预测与可解释分析模型. 计算机应用研究,2025, 42(2): 357-364
[6] 王鑫, 邹磊, 王朝坤, 等. 知识图谱数据管理研究综述. 软件学报, 2019, 30(7): 2139-2174
[7] Endris K M, Galkin M, Lytra I, et al. Querying interlinked data by bridging RDF molecule templates. Transactions on Large-Scale Data and Knowledge Centered Systems, 2018, 39: 1-42
[8] 龙洪. 数据中心资源调度中的虚拟化技术研究. 信息与电脑, 2025, 37(1): 86-88
[9] 李跃鹏, 温亮明, 黎建辉. 基于查询语言转换的多源数据统一访问框架. 计算机系统应用, 2021, 30(9): 53-61
[10] 暴琳, 朱志宇, 孙晓燕, 等. 面向多源异构数据的个性化搜索和推荐算法综述. 控制理论与应用,2024, 41(2): 189-209
[11] Xiao G, Ding L, CogrelB., et al. Virtual knowledge graphs: an overview of systems and use cases. Data Intelligence, 2019, 1: 201-223
[12] Kurniawan K, Ekelhart A, Kiesling E, et al. Vlo-Graph:a virtual knowledge graph framework for distributed security log analysis. Machine Learning and Knowledge Extraction, 2022, 4(2): 371-396
[13] Belmehdi K C, Khiat A, Keskes N. Predicting an optimal virtual data model for uniform access to large heterogeneous data. Data Intelligence, 2024, 6(2):504-530
[14] Priyatna F, Corcho Ó, Sequeda J. Formalisation and experiences of R2RML-based SPARQL to SQL query translation using morph // Proceedings of the 23rd international conference. New York: Association for Computing Machinery, 2014: 479-489
[15] Chaves-Fraga D, Ruckhaus E, Priyatna F, et al. Enhancing virtual ontology based access over tabular data with Morph-CSV. Semantic Web, 2021, 12: 869-902
[16] Calvanese D, Cogrel B, Komla-Ebri S, et al. Ontop: answering SPARQL queries over relational databases.Semantic Web, 2016, 8: 471-487
[17] Mami M N, Graux D, Scerri S, et al. Squerall: virtual ontology-based access to heterogeneous and large data sources // International Workshop on the Semantic Web. Berlin: Springer-Verlag, 2019: 1-14
[18] Reham O, Ishika D, Panos K, et al. A universal question-answering platform for knowledge graphs. Proceedings of the ACM on Management of Data, 2023,1(1): 1-25
[19] Charalambidis A, Troumpoukis A, Konstan-topoulos S.SemaGrow: optimizing federated SPARQL queries //Proceedings of the 11th International Conference on Semantic Systems. Vienna: ACM, 2015: 121-128
[20] 姜红玉, 谢胜飞, 姜鑫, 等. 多源异构数据统一存储共享管理系统. 科技和产业, 2024, 24(18): 88-93
[21] Zhang Y, Chen P, Ives Z. Searching data lakes for nested and joined data. Proceedings of the VLDB Endowment, 2024, 17(11): 3346-3359
[22] Zhu J, Mao Y, Chen L, et al. FusionQuery: on-demand fusion queries over multi-source heterogeneous data.Proceedings of the VLDB Endowment, 2024, 17:1337-1349
[23] Zhang W, Jin L, Zhu Y, et al. TrustUQA: a trustful framework for unified structured data question answering [EB/OL]. (2024-06-27)[2025-05-01]. https://arxiv.org/abs/2406.18916
[24] Endris K M, Rohde P D, Vidal M E, et al. Ontario:federated query processing against a semantic data lake // Proceedings of the 30th International Conference on Database and Expert Systems Applications. Berlin:Springer-Verlag, 2019: 379-395
[25] Hasnain A, Mehmood Q, Zainab S S, et al. BioFed:federated query processing over life sciences linked open data. Journal of Biomedical Semantics, 2017, 8:13-32